
ComfyUIの画面を開いて、そっと閉じた。
複数のボックスが並んでいて、それらを結ぶ線が複雑に張り巡らされているComfyUIの画面を見たことがある方も多いのではないでしょうか。
ただし標準の画面に並んでいる箱は6つだけです。それぞれの役割を理解しておけば、接続線の意味も自然と把握できるようになります。
実際の画面を確認しながら、1つずつ順番に進めていきます。
ComfyUIそのものについてはComfyUIとは?13枚作って速さと品質を測りましたにまとめています。
結論:箱は6つ、やっていることは一本道です
先に全体像です。標準のワークフローは、次の順に流れます。
| 順 | 箱の名前 | やっていること |
|---|---|---|
| 1 | Load Checkpoint | モデルを読み込みます |
| 2 | CLIP Text Encode(上) | 作りたいものの文章を入れます |
| 3 | CLIP Text Encode(下) | 入れたくないものを書きます |
| 4 | Empty Latent Image | 出力サイズと枚数を決めます |
| 5 | KSampler | 実際に絵を作ります(ここが本体) |
| 6 | VAE Decode | できたものを画像に変換します |
分岐する経路は存在しません。左側から右側へ向けて、素材を順に流すだけのシンプルな設計です。
これが実際の画面です
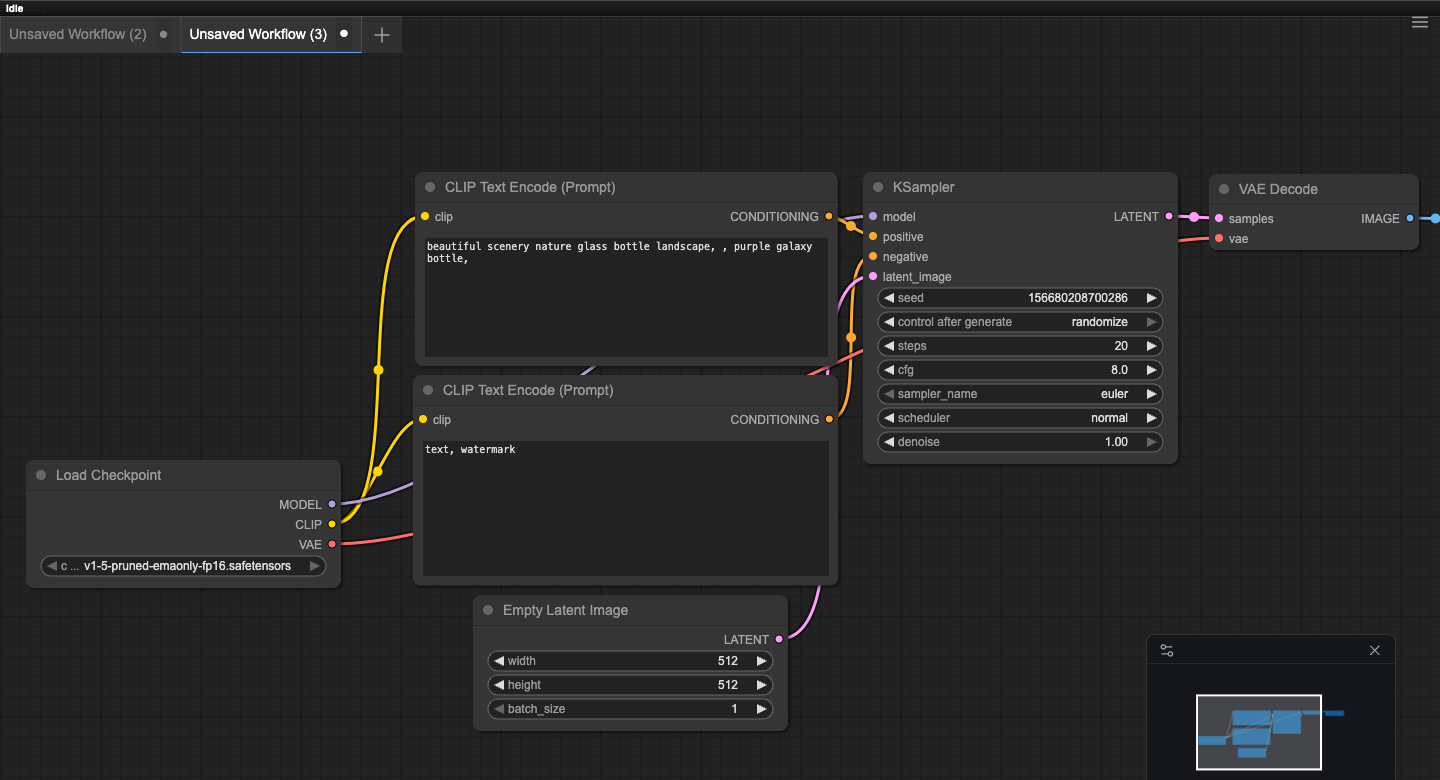
起動して標準のワークフローを開くと、こうなっています。
ワークフローの流れとしては、左下のLoad Checkpointから始まり、右端のVAE Decodeで完了します。中央に2つ配置されているのは、プロンプトを入力するためのノードです。
線の色が、運んでいるものを表します
線が複雑に絡み合っているように見えますが、色ごとに運ぶ対象が決まっています。
| 線の名前 | 運んでいるもの | どこからどこへ |
|---|---|---|
| MODEL | 絵を描くAI本体 | Load Checkpoint → KSampler |
| CLIP | 文章を理解する部分 | Load Checkpoint → 文章の箱2つ |
| CONDITIONING | 文章を数値に変えたもの | 文章の箱 → KSampler |
| LATENT | まだ画像になる前のデータ | サイズの箱 → KSampler → VAE Decode |
| IMAGE | できあがった画像 | VAE Decode → 保存 |
同じ色の点どうししかつながりません。間違った線を引こうと試みても、接続自体が成立しない仕組みになっているため、この特性を理解すれば急に怖くなくなります。
スタート地点はモデルの読み込みです
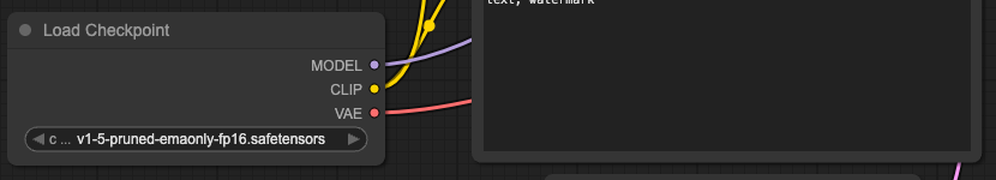
いちばん左のボックスで、使用するモデルを選択します。
1つのファイルに複数の役割が含まれている点が特徴です。MODEL・CLIP・VAEの3要素が独立した出力先へと振り分けられます。
文章の箱は2つあります
画面の中央には同じ形状のボックスが2つ配置されています。いずれもテキストを入力する領域ですが、その機能は正反対です。
- 上(positiveにつながるほう):作りたいイメージを記述する欄です。今回の検証では『beautiful scenery nature glass bottle landscape, purple galaxy bottle』と入力していました。
- 下(negativeにつながるほう):入れたくない要素を指定する欄です。ここでは『text, watermark』が設定されていました。
見た目が同じなので、どちらがどちらか分かりません。線をたどって、KSamplerのpositiveにつながっているほうが「作りたいもの」です。
KSamplerが本体です
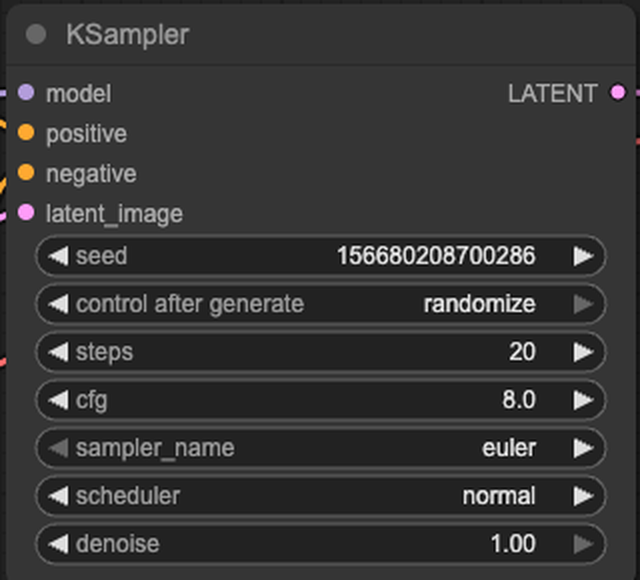
ここが実際に絵を作っている箱です。設定項目が7つあります。
7つの設定の意味
1つずつ書きます。
| 項目 | 意味 | 触り方 |
|---|---|---|
| seed | 乱数の種。同じ値なら同じ絵になります | 気に入った絵が出たら控えます |
| control after generate | 作るたびにseedをどうするか | randomizeなら毎回変わります |
| steps | 何回描き込むか | 増やすと遅く、丁寧になります |
| cfg | 文章にどれだけ忠実にするか | 高すぎると絵が硬くなります |
| sampler_name | 描き方の方式 | eulerのままで問題ありません |
| scheduler | 描き込む配分の決め方 | normalのままで大丈夫です |
| denoise | どれだけ描き直すか | 文章から作るなら1.00です |
最初に触るならstepsだけで十分です。当サイトの検証では、Fluxで4ステップだと5.6秒・輪郭が甘く、8ステップで8.0秒・実用になり、20ステップで25.1秒という結果になりました。
サイズの箱と、最後の変換
残りの2つも短く説明します。
- Empty Latent Image:width・height・batch_sizeの3つだけです。画面では512×512、1枚の設定でした。batch_sizeを増やすと一度に複数枚作れます
- VAE Decode:KSamplerが作ったデータを、実際に見られる画像に変換します。設定項目はありません。通り道と考えて大丈夫です
なお解像度は大きければ良いわけではありません。SD 1.5で1024×1024にすると、被写体が増えたり崩れたりしました。基本的にはモデルが学習したサイズに合わせて設定することをおすすめします。
自分で組む必要はありません
ここまで読んで「結局組むのが大変そう」と思われたかもしれません。
実際には、テンプレートから選べば線は最初からつながっています。起動して最初に出る画面がテンプレートの一覧で、Text to ImageやImage to Videoといった目的が並んでいます。
自分でノードを接続するのは、既存のテンプレートで足りなくなってからで十分です。まずは標準のワークフローを選び、KSamplerのstepsとseedだけ調整してみることをおすすめします。
検証しきれなかったこと
今回わからなかった点です。
- 自分でノードを追加してつなぐ操作を試していません。今回は画面を読む側に絞っています。
- ワークフローの保存と読み込みも未検証です。
- 複雑なワークフロー(動画生成など)の画面は撮れていません。モデルのダウンロードでつまずいたためです。
- ノードの並びや項目名はバージョンで変わります。この記事は2026年8月時点のものです。
よくある質問(FAQ)
最後に、よくある質問をまとめておきます。
ComfyUIのワークフローとは何ですか?
画像を作る手順を、箱(ノード)と線でつないで表したものです。標準の画面では箱が6つ並んでいて、モデルの読み込みから画像の出力まで一本道で流れます。枝分かれはありません。
線が多くて読めません
ComfyUIでは、接続できる線の色によって受け渡すデータの種類が決まっています。具体的には、MODELがAI本体、CLIPが文章を理解する部分、CONDITIONINGが文章を数値化したもの、LATENTが画像になる前のデータ、IMAGEが完成品です。同じ色のノード同士のみ接続可能であるため、異なる色の間違った線は引くことができません。
文章を入れる箱が2つあるのはなぜですか?
作りたいものと、入れたくないものを分けて書くためです。見た目が同じなので、線をたどってKSamplerのpositiveにつながっているほうが「作りたいもの」と判断しましょう。
KSamplerの設定はどれを触ればいいですか?
まずはstepsとseedの2つの項目だけ設定すれば十分です。stepsは描き込む回数を表し、数値を増やすと処理時間は長くなりますが、代わりに仕上がりが丁寧になります。seedは同じ値を設定すれば同じ絵が生成されるため、気に入った作品が出た場合はその値を記録しておくとよいです。
ワークフローは自分で組む必要がありますか?
ComfyUIを起動して最初に出るテンプレートの一覧から選ぶと、ノード間の接続はすでに設定済みです。自分で線を引く必要はなく、既存のテンプレートで足りなくなった段階で追加すれば十分です。
まとめ
ComfyUIの画面は、箱6つの一本道という構成になっています。モデルを読み込み、プロンプトを2つ入力し、サイズを指定してKSamplerで生成し、最後に画像へ変換する流れです。
線の接続ルールは明確で、同じ色どうししかつながりません。そのため、意図せず間違った線が引かれる心配はありません。
まずはKSamplerのstepsとseedの2つだけを変えて試すのがおすすめです。テンプレートを選ぶと線が最初からつながった状態になるため、複雑な設定をせず、気軽に開いて操作してみてください。

コメント